เครื่องเวกเตอร์สนับสนุนสำหรับการจำแนกประเภทบนผลตอบแทน SET100

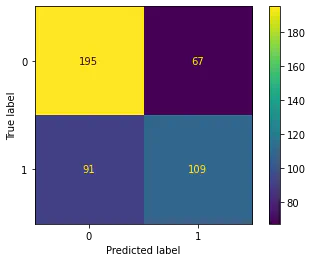 เมทริกซ์ความสับสน
หมายเหตุ
โครงการนี้เป็นการสอบ CQF ในเรื่องการเรียนรู้ของเครื่องในด้านการเงิน
ความเข้าใจปัญหา
ดัชนี SET100 ซึ่งเป็นตัวแทนของหุ้น 100 ตัวบนตลาดหลักทรัพย์แห่งประเทศไทย (SET) ทำหน้าที่เป็นตัวชี้วัดที่สำคัญสำหรับตลาดหุ้นของไทย แตกต่างจากดัชนีที่เป็นที่ยอมรับในตลาดพัฒนาหรือประเทศที่พัฒนาแล้ว เช่น S&P 500 หรือ FTSE 100 ดัชนี SET100 เผชิญกับสภาพเศรษฐกิจที่เปลี่ยนแปลงอย่างรวดเร็วของตลาดเกิดใหม่ ตลาดเกิดใหม่อย่างประเทศไทยมีศักยภาพในการเติบโตที่สูงขึ้นเนื่องจากการอุตสาหกรรม, การขยายตัวของเมือง และโครงสร้างประชากรที่เอื้ออำนวย อย่างไรก็ตาม การเติบโตนี้มาพร้อมกับความผันผวนที่เพิ่มขึ้นและความเสี่ยงที่สูงขึ้น ซึ่งได้รับอิทธิพลจากความไม่มั่นคงทางการเมือง, ความผันผวนทางเศรษฐกิจ และผลกระทบจากเศรษฐกิจโลกSET100 มอบโอกาสการลงทุนที่โดดเด่นในหลายสาขา รวมถึงการเงิน พลังงาน สินค้าอุปโภคบริโภค และอุตสาหกรรม การรวมเอาธุรกิจขนาดเล็กถึงขนาดกลางเข้าสู่ดัชนีนี้เน้นศักยภาพในการเติบโตอย่างมีนัยสำคัญ คุณลักษณะเหล่านี้ พร้อมกับความท้าทายและโอกาสที่มีอยู่ในตลาดเกิดใหม่ ทำให้ SET100 เป็นหัวข้อที่น่าสนใจสำหรับการวิเคราะห์ทางการเงินและการคาดการณ์ผลตอบแทนการทำนายผลตอบแทนของหุ้นอย่างแม่นยำเป็นสิ่งสำคัญสำหรับการตัดสินใจลงทุนอย่างมีข้อมูล ตลาดการเงินที่ผันผวนและซับซ้อน พร้อมปัจจัยต่าง ๆ เช่น ความรู้สึกของตลาด ตัวชี้วัดทางเศรษฐกิจ และเหตุการณ์ทางภูมิรัฐศาสตร์ ก่อให้เกิดความท้าทายอย่างมากต่อการทำนายผลตอบแทน วิธีการทางสถิติแบบดั้งเดิมมักไม่สามารถจับความสัมพันธ์แบบไม่เชิงเส้นภายในข้อมูลได้ ทำให้ต้องพึ่งพาเทคนิคการเรียนรู้ของเครื่องที่ล้ำหน้า ในโครงการนี้ เราใช้เครื่องมือ Support Vector Machines (SVM) เพื่อจำแนกผลตอบแทนรายวันของหุ้น SET100 โดยใช้ความสามารถของอัลกอริทึมในการจัดการข้อมูลมิติสูงและจำลองรูปแบบที่ซับซ้อน เป้าหมายของเราคือการเพิ่มความแม่นยำในการทำนาย เพื่อให้ข้อมูลเชิงลึกที่มีคุณค่าสำหรับนักลงทุนและผู้จัดการพอร์ตโฟลิโอ
การดึงข้อมูลข้อมูลสำหรับการศึกษานี้ รวมถึงราคาสำหรับเปิด สูง ต่ำ และปิด (OHLC) ของหุ้น SET100 ถูกดึงมาจาก Investing.com ชุดข้อมูลครอบคลุมตั้งแต่วันที่ 3 มกราคม 2018 ถึง 30 พฤษภาคม 2024 ให้ข้อมูลราคาประวัติศาสตร์อย่างครบถ้วน ที่นี่ ราคาทั้งหมดปรับตามเงินปันผลและนำเสนอเป็นสกุลเงินบาท (THB) หลังจากดึงข้อมูลมา ข้อมูลได้ผ่านกระบวนการทำความสะอาดอย่างละเอียดเพื่อให้มั่นใจในคุณภาพและความน่าเชื่อถือ กระบวนการนี้รวมถึงการจัดการกับค่าที่หายไป การลบข้อมูลซ้ำ และการทำให้รูปแบบวันที่สอดคล้องกัน
การสร้างภาพข้อมูล/คำอธิบายชุดข้อมูลประกอบด้วยคุณลักษณะหลักดังต่อไปนี้:
- เปิด (Open): ราคาหุ้นเปิดในวันซื้อขายที่กำหนด
- สูง (High): ราคาหุ้นสูงสุดในช่วงวันซื้อขาย
- ต่ำ (Low): ราคาหุ้นต่ำสุดในช่วงวันซื้อขาย
- ปิด (Close): ราคาหุ้นปิดในวันซื้อขาย
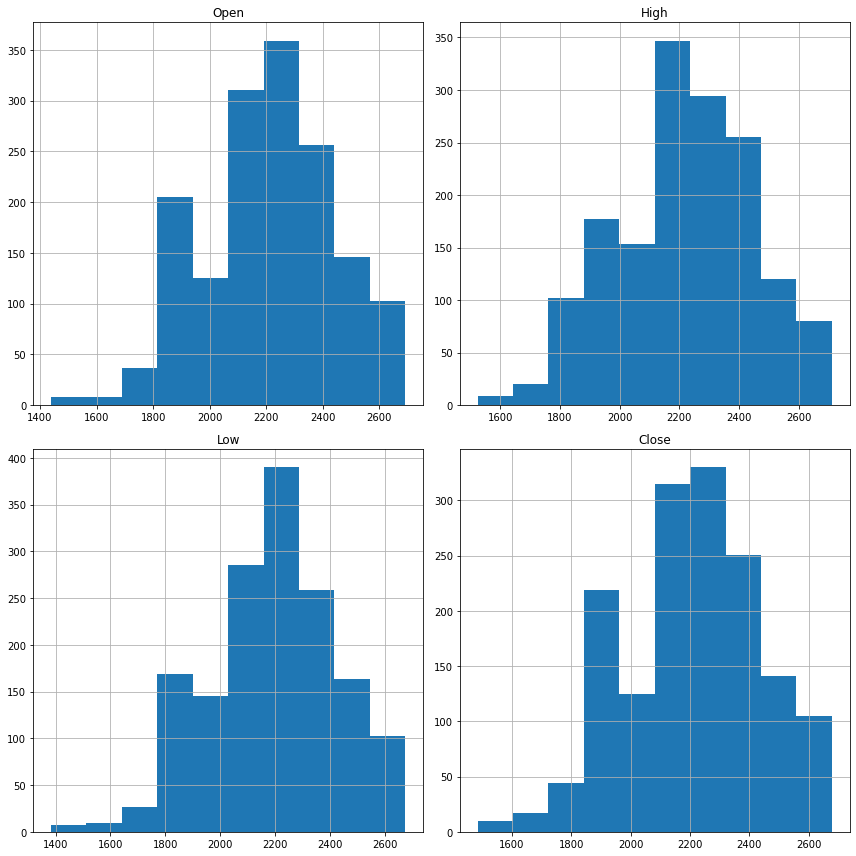
รูปที่ 1 แสดงการกระจายตัวของคุณลักษณะที่เลือกบางประการ ซึ่งให้ข้อมูลเชิงลึกเกี่ยวกับช่วงและแนวโน้มศูนย์กลางของพวกมัน ข้อมูลไม่มีค่าผิดปกติสุดโต่ง เนื่องจาก SET100 ไม่เติบโตอย่างรวดเร็วเมื่อเทียบกับตลาดอื่นและช่วงเวลาการศึกษาเป็นระยะเวลาสั้น ๆ ฮิสโตแกรมของคุณลักษณะต่าง ๆ แสดงแนวโน้มศูนย์กลาง นอกจากนี้คุณลักษณะเหล่านี้มีความสัมพันธ์กันสูง การสร้างคุณลักษณะเพิ่มเติมเป็นสิ่งจำเป็นเพื่อจับรูปแบบที่แท้จริงและปรับปรุงประสิทธิภาพของโมเดล
การทำความสะอาด/จัดการข้อมูลการทำความสะอาดและจัดการข้อมูลอย่างมีประสิทธิภาพเป็นขั้นตอนสำคัญในการเตรียมชุดข้อมูลสำหรับการวิเคราะห์และสร้างแบบจำลอง ในการศึกษานี้ ชุดข้อมูลซึ่งประกอบด้วยข้อมูลราคาประวัติศาสตร์ของดัชนี SET100 ได้ผ่านกระบวนการทำความสะอาดข้อมูลอย่างละเอียดเพื่อให้มั่นใจในคุณภาพและความน่าเชื่อถือของข้อมูล
การจัดการค่าที่หายไป
ค่าที่หายไปในชุดข้อมูลสามารถทำให้ผลลัพธ์ไม่ถูกต้องและเกิดอคติในแบบจำลอง เพื่อแก้ไขปัญหานี้ เราได้ดำเนินการตามขั้นตอนดังต่อไปนี้:
- ระบุค่าที่หายไปในชุดข้อมูล
- เติมค่าที่หายไปโดยใช้วิธีเติมต่อจากค่าก่อนหน้าหรือค่าหลังที่เหมาะสม
- สำหรับคุณสมบัติที่ไม่เหมาะสมกับการเติมค่า แถวที่มีค่าหายไปจะถูกลบออกเพื่อรักษาความสมบูรณ์ของข้อมูล
การลบข้อมูลซ้ำ
ระเบียนที่ซ้ำซ้อนสามารถทำให้การวิเคราะห์ผิดเพี้ยนและนำไปสู่ข้อสรุปที่ไม่ถูกต้อง เรารับประกันว่าชุดข้อมูลปราศจากข้อมูลซ้ำโดย:- ระบุและลบแถวที่ซ้ํากันตามคอลัมน์ ‘วันที่’
ในกระบวนการนี้ 70.% ของข้อมูลถูกจัดสรรให้กับชุดฝึก และ 30.% ไปยังชุดทดสอบพารามิเตอร์ \texttt{random_state} ถูกตั้งเป็น 42 เพื่อให้มั่นใจว่าผลลัพธ์สามารถทําซ้ําได้
วิศวกรรมฟีเจอร์
ตารางต่อไปนี้แสดงคุณลักษณะที่ถูกแปลง คําอธิบาย และสูตรทางคณิตศาสตร์ที่ใช้คํานวณ:|คุณสมบัติ |คําอธิบาย |สูตรคณิตศาสตร์ | |————————|———————————————————————————————————————————-|————————————————| |ความผันผวน |ส่วนเบี่ยงเบนมาตรฐานของผลตอบแทนในช่วงเวลา 10 วันแสดงระดับความผันผวนของราคาหุ้น แสดงถึงความไม่แน่นอนและความเสี่ยงของตลาด|$\text{std}(\text{Return}_{t-10:t-1})$ | |โมเมนตัม |ความแตกต่างระหว่างราคาปิดปัจจุบันกับราคาปิดเมื่อ 10 วันที่แล้วฟีเจอร์นี้ช่วยระบุแนวโน้มและความแข็งแกร่งของการเคลื่อนไหวของราคาหุ้น|$\text{ปิด}_{t-10} - \text{ปิด}_{t-20}$ || Avg_Open_Close | ค่าเฉลี่ยของราคาปิดและราคาเปิด ให้ค่าที่เรียบง่ายซึ่งแสดงถึงแนวโน้มศูนย์กลางของราคาภายในวันซื้อขาย | $ rac{ ext{Open}_{t-1} + ext{Close}_{t-1}}{2}$ | | Avg_High_Low | ค่าเฉลี่ยของราคาสูงสุดและราคาต่ำสุด ให้ข้อมูลเกี่ยวกับช่วงความผันผวนของราคาในแต่ละวัน แสดงถึงความผันผวนภายในวันซื้อขายเดียว | $ rac{ ext{High}_{t-1} + ext{Low}_{t-1}}{2}$ | | Price_Range | ความต่างระหว่างราคาสูงสุดและราคาต่ำสุด คุณสมบัตินี้แสดงการเคลื่อนไหวของราคาภายในวัน | $ ext{High}_{t-1} - ext{Low}_{t-1}$ | | Daily_Change | ความต่างระหว่างราคาปิดและราคาเปิด | $ ext{Close}_{t-1} - ext{Open}_{t-1}$ || เปอร์เซ็นต์การเปลี่ยนแปลงรายวัน | การเปลี่ยนแปลงรายวันเป็นเปอร์เซ็นต์ของราคาปิด เปิด เพื่อให้มุมมองที่ปรับมาตรฐานของการเปลี่ยนแปลงราคาประจำวัน | $ rac{ ext{Daily_Change}_{t}}{ ext{Open}_{t-1}} imes 100$ | | ค่าเฉลี่ยเคลื่อนที่ของราคาปิด | ค่าเฉลี่ยเคลื่อนที่ของราคาปิดในช่วง 10 วัน ให้แนวโน้มราคาปิดที่เรียบขึ้น | $ ext{mean}( ext{Close}_{t-10:t-1})$ | | ค่าเฉลี่ยเคลื่อนที่ของความผันผวน | ค่าเฉลี่ยเคลื่อนที่ของความผันผวนในช่วง 10 วัน เน้นแนวโน้มระยะยาวของความผันผวนในตลาด | $ ext{mean}( ext{Volatility}_{t-10:t-1})$ | | ค่าเฉลี่ยเคลื่อนที่ของโมเมนตัม | ค่าเฉลี่ยเคลื่อนที่ของโมเมนตัมในช่วง 10 วัน ช่วยในการระบุแนวโน้มที่ต่อเนื่องของการเคลื่อนไหวของราคา | $ ext{mean}( ext{Momentum}_{t-10:t-1})$ |ด้วยการออกแบบคุณสมบัติเหล่านี้ เราได้เปลี่ยนข้อมูลราคาหุ้นดิบให้เป็นชุดข้อมูลที่มีโครงสร้างซึ่งจับตัวชี้วัดทางการเงินที่สําคัญ ช่วยให้สามารถสร้างแบบจําลองและทํานายได้อย่างมีประสิทธิภาพด้วยแนวทาง SVM
การสร้างแบบจําลองข้อมูล
รองรับเครื่องเวกเตอร์
SVM ทํางานโดยหาไฮเปอร์เพลนที่แยกคลาสในพื้นที่ฟีเจอร์ได้ดีที่สุดไฮเปอร์เพลนถูกเลือกเพื่อเพิ่มขอบเขตสูงสุด ซึ่งเป็นระยะห่างระหว่างไฮเปอร์เพลนกับจุดข้อมูลที่ใกล้ที่สุดจากแต่ละคลาส
สําหรับ SVM เชิงเส้น ฟังก์ชันการตัดสินใจถูกกําหนดไว้ดังนี้:
$$ f(\mathbf{x}) = \mathbf{w} \cdot \mathbf{x} + b $$โดยที่ $\mathbf{w}$ คือเวกเตอร์น้ําหนัก, $\mathbf{x}$ คือเวกเตอร์อินพุต และ $b$ คือเทอมไบแอสไฮเปอร์เพลนถูกกําหนดโดยสมการ $\mathbf{w} \cdot \mathbf{x} + b = 0$วัตถุประสงค์ของ SVM คือการเพิ่มมาร์จิ้นให้สูงสุดในขณะที่จัดประเภทข้อมูลฝึกสอนอย่างถูกต้องซึ่งสามารถกําหนดเป็นปัญหาการเพิ่มประสิทธิภาพที่มีข้อจํากัด:
$$ \min_{\mathbf{w}, b} \frac{1}{2} \|\mathbf{w}\|^2 + C \sum_{i=1}^{n} \xi_i $$ $$ \text{subject to } y_i (\mathbf{w} \cdot \mathbf{x}_i + b) \geq 1 \quad \forall i $$โดยที่ $y_i$ คือป้ายกํากับของคลาส และ $\mathbf{x}_i$ คือเวกเตอร์อินพุต, $\xi_i \geq 0 \quad \forall i$, และ $C$ คือพารามิเตอร์การทําให้เป็นปกติ
ค่าที่มากขึ้น $C$ จะเน้นการลดข้อผิดพลาดในการจัดประเภทผิดให้น้อยที่สุด ซึ่งอาจแลกมาด้วยขอบเขตที่น้อยลงสิ่งนี้อาจนําไปสู่โมเดลที่ตรงกับข้อมูลการฝึกอย่างใกล้ชิด (อคติต่ําแต่ความแปรปรวนสูง) ซึ่งอาจนําไปสู่การ overfitting
ในทางกลับกัน ค่าที่เล็กลง $C$ จะเน้นการเพิ่มมาร์จิ้นให้สูงสุด ทําให้เกิดการจัดประเภทผิดพลาดบางอย่างสิ่งนี้อาจนําไปสู่โมเดลที่ง่ายขึ้นซึ่งสามารถขยายผลได้ดีขึ้นกับข้อมูลที่ไม่เคยเห็น (อคติสูงแต่ความแปรปรวนต่ํา) ลดความเสี่ยงของการฟิตเกินโครงการนี้ใช้เทคนิคเคอร์เนลกับเคอร์เนลเชิงเส้น, RBF และซิกมอยด์ ตามที่สามารถพบได้ในภาคผนวก \ref{app:A}.
การเลือกแบบจำลองผ่านการปรับพารามิเตอร์
เพื่อเพิ่มประสิทธิภาพของแบบจำลอง SVM เราได้ใช้ Grid Search ซึ่งเป็นวิธีแบบเป็นระบบในการปรับพารามิเตอร์ Grid Search เกี่ยวข้องกับการประเมินผลการทำงานของแบบจำลองผ่านชุดพารามิเตอร์ที่กำหนดล่วงหน้าเพื่อหาชุดค่าที่ให้ผลลัพธ์ดีที่สุด
ในการศึกษานี้ เราได้พิจารณาพารามิเตอร์สำคัญสามตัวสำหรับแบบจำลอง SVM:- $C$: พารามิเตอร์การทําให้เป็นปกติ ซึ่งควบคุมการแลกเปลี่ยนระหว่างการได้ค่าความคลาดเคลื่อนต่ําในข้อมูลฝึกสอนและการลดความซับซ้อนของโมเดลเพื่อหลีกเลี่ยงการฟิตเกิน
- $\gamma$: สัมประสิทธิ์เคอร์เนลสําหรับเคอร์เนลที่ไม่เชิงเส้น (เช่น ฟังก์ชันฐานรัศมี RBF)มันกําหนดขอบเขตของอิทธิพลของตัวอย่างฝึกสอนเพียงหนึ่งตัว โดยค่าต่ําหมายถึง ‘ไกล’ และค่าสูงหมายถึง ‘ใกล้’
- เคอร์เนล: ประเภทของฟังก์ชันเคอร์เนลที่ใช้ในการแปลงข้อมูลนําเข้าเราพิจารณาเคอร์เนลสองประเภท ได้แก่ ฟังก์ชันฐานเชิงเส้นและเรเดียล และเคอร์เนลซิกมิโอดเราได้กําหนดกริดของไฮเปอร์พารามิเตอร์โดยมีค่าดังนี้ $C \in \{0.1, 1, 10, 100\}$, $\gamma \in \{1, 0.1, 0.01, 0.001\}$ และเคอร์เนลสามประเภทที่เคยเป็นดิสปัสก่อนหน้านี้กริดที่กําหนดข้างต้นให้ผลลัพธ์รวมทั้งหมด 48 ชุด (4 ค่าสําหรับ $C$, 4 ค่าสําหรับ $\gamma$ และ 3 ค่าสําหรับเคอร์เนล)แต่ละค่าถูกประเมินเพื่อกําหนดชุดไฮเปอร์พารามิเตอร์ที่เหมาะสมที่สุด หลังจากทําการค้นหาแบบกริด พบว่าพารามิเตอร์ที่ดีที่สุดคือ: $C = 1$ ในเคอร์เนลเชิงเส้น
ในทางปฏิบัติ ไลบรารี scikit-learn ของ Python ใช้อัลกอริทึม Sequential Minimal Optimization (SMO) [2] เพื่อแก้ปัญหาการปรับแต่ง SVM แบบคู่ [1]SMO แบ่งปัญหาออกเป็นปัญหาย่อยย่อย โดยแต่ละปัญหาเกี่ยวข้องกับตัวคูณ Lagrange เพียงสองตัวในแต่ละครั้ง ซึ่งทําให้การปรับแต่งมีประสิทธิภาพและขยายตัวได้มากขึ้นรายละเอียดสามารถดูได้ในภาคผนวก \ref{app:smo}## การตรวจสอบ/พัฒนาโมเดล
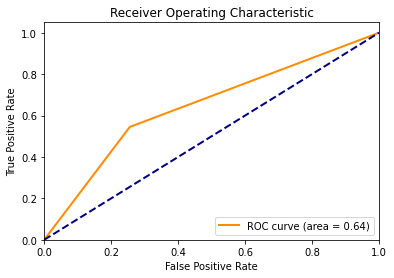
ประสิทธิภาพของโมเดลแสดงไว้ในตาราง \ref{tab:classification_report}โมเดล SVM มีความแม่นยํา 65.80% ซึ่งบ่งชี้ถึงอัตราการทํานายที่ถูกต้องสูงความแม่นยําสําหรับคลาส 0.0 (ผลตอบแทนลบ) อยู่ที่ 0.68 และสําหรับคลาส 1.0 (ผลตอบแทนบวก) อยู่ที่ 0.62 แสดงให้เห็นถึงความสามารถของโมเดลในการระบุผลตอบแทนลบได้แม่นยํากว่าผลตอบแทนบวกการเรียกคืนสําหรับคลาส 0.0 อยู่ที่ 0.74 และสําหรับคลาส 1.0 คือ 0.55 ซึ่งบ่งชี้ว่าโมเดลสามารถระบุผลตอบแทนลบจริงส่วนใหญ่ได้สําเร็จ แต่น้อยกว่าสําหรับผลตอบแทนบวกคะแนน F1 สําหรับทั้งสองคลาสอยู่ในระดับปานกลาง (0.71 สําหรับคลาส 0.0 และ 0.58 สําหรับคลาส 1.0) สะท้อนถึงความสมดุลระหว่างความแม่นยําและการเรียกคืนคะแนน ROC AUC 0.64 ยังยืนยันความสามารถในการแยกแยะผลตอบแทนบวกและลบของโมเดลนี้อีกด้วยเมทริกซ์ความสับสน (Confusion Matrix) ซึ่งแสดงในรูปที่ 2 ให้ข้อมูลเชิงลึกอย่างละเอียดเกี่ยวกับการทำนายของโมเดล จากการทำนายทั้งหมด 462 ครั้ง โมเดลทำการทำนายที่ถูกต้องและไม่ถูกต้องอย่างสมดุลสำหรับทั้งสองคลาส โดยเฉพาะ โมเดลทำนายค่า True Negative ถูกต้อง 194 ครั้ง และ True Positive ถูกต้อง 110 ครั้ง ซึ่งชี้ให้เห็นความน่าเชื่อถือของโมเดลในการแยกความแตกต่างระหว่างสองคลาส แต่ก็ยังมีพื้นที่ที่ต้องปรับปรุง
ค่า ROC AUC ซึ่งย่อมาจาก Receiver Operating Characteristic Area Under Curve ที่แสดงในรูปที่ 3 เป็นเครื่องวัดความสามารถของโมเดลในการแยกแยะระหว่างคลาส ค่า ROC AUC 0.64 แสดงถึงระดับการแยกแยะปานกลางระหว่างผลตอบแทนเชิงบวกและลบ แสดงให้เห็นว่าโมเดลดีกว่าการเดาสุ่ม แต่ยังมีพื้นที่ปรับปรุงอยู่
ข้อสรุปเกี่ยวกับการซื้อขายความแม่นยำและตัวชี้วัดประสิทธิภาพในระดับปานกลางของโมเดล SVM บ่งชี้ถึงความเป็นไปได้ในการประยุกต์ใช้ในกลยุทธ์การซื้อขายทางการเงิน ตัวอย่างเช่น การทำนายผลตอบแทนเป็นบวก (คลาส 1.0) อาจทำหน้าที่เป็นสัญญาณซื้อ ในขณะที่การทำนายผลตอบแทนเป็นลบ (คลาส 0.0) อาจบ่งชี้ถึงการขายหรือการถือครอง ความสามารถในการทำนายนี้สามารถผนวกรวมเข้ากับระบบการซื้อขายอัตโนมัติเพื่อปรับปรุงกระบวนการตัดสินใจ นอกจากนี้ การรวมกลยุทธ์การบริหารความเสี่ยง เช่น การตั้งคำสั่งหยุดขาดทุนตามการทำนายความผันผวน สามารถลดความสูญเสียที่อาจเกิดขึ้นได้ การปรับแต่งพอร์ตโฟลิโอยังสามารถได้รับประโยชน์จากการทำนายเหล่านี้โดยการกระจายการลงทุนไปยังหลายหุ้นใน SET100 เพื่อสร้างความสมดุลระหว่างความเสี่ยงและผลตอบแทน| มาตรฐาน|ความแม่นยำ|การดึงข้อมูล|F1-Score|จำนวนตัวอย่าง | |—————–|—————|————|————–|————-| | 0 | 0.68 | 0.74 | 0.71 | 262 | | 1 | 0.62 | 0.55 | 0.58 | 200 | | ความถูกต้อง | 0.66 | 0.66 | 0.66 | 462 | | ค่าเฉลี่ยแบบมาโคร | 0.65 | 0.64 | 0.65 | 462 | | ค่าเฉลี่ยถ่วงน้ำหนัก| 0.65 | 0.66 | 0.65 | 462 |
ตาราง: รายงานการจำแนกประเภทและมาตรฐาน
ภาคผนวก
เทคนิคเคอร์เนลSVM สามารถทําการจําแนกแบบไม่เชิงเส้นได้อย่างมีประสิทธิภาพโดยใช้ฟังก์ชันเคอร์เนลเคอร์เนลจะแปลงข้อมูลนําเข้าเป็นพื้นที่มิติที่สูงขึ้น ซึ่งสามารถใช้ตัวแยกเชิงเส้นเพื่อแยกความแตกต่างระหว่างคลาสต่าง ๆที่นี่ เราจะอธิบายเคอร์เนลที่ใช้กันทั่วไปสามประเภท ได้แก่ ฟังก์ชันเชิงเส้น, ฟังก์ชันฐานรัศมี (RBF) และซิกมอยด์
เคอร์เนลเชิงเส้น
เคอร์เนลเชิงเส้นเป็นเคอร์เนลประเภทที่ง่ายที่สุด ใช้เมื่อข้อมูลสามารถแยกเชิงเส้นในพื้นที่ฟีเจอร์เดิมได้ขอบเขตการตัดสินใจเป็นไฮเปอร์เพลนในพื้นที่ฟีเจอร์เดิม
ในทางคณิตศาสตร์ ฟังก์ชันเคอร์เนลเชิงเส้นถูกกําหนดไว้ดังนี้:
$$ K(\mathbf{x}_i, \mathbf{x}_j) = \mathbf{x}_i \cdot \mathbf{x}_j $$โดยที่ $\mathbf{x}_i$ และ $\mathbf{x}_j$ เป็นเวกเตอร์อินพุต และ $\cdot$ หมายถึงผลคูณจุด
ฟังก์ชันการตัดสินใจสําหรับเคอร์เนลเชิงเส้นกําหนดโดย:
$$ f(\mathbf{x}) = \mathbf{w} \cdot \mathbf{x} + b $$โดยที่ $\mathbf{w}$ คือเวกเตอร์น้ําหนัก และ $b$ คือเทอมไบแอส
เคอร์เนลฟังก์ชันฐานรัศมี (RBF)เคอร์เนล RBF หรือที่รู้จักกันในชื่อเคอร์เนลเกาส์เซียน เป็นตัวเลือกยอดนิยมสําหรับ SVM เพราะสามารถจัดการความสัมพันธ์ที่ไม่เชิงเส้นโดยการแมปข้อมูลไปยังพื้นที่มิติอนันต์มันมีประสิทธิภาพเป็นพิเศษเมื่อขอบเขตการตัดสินใจไม่เป็นเชิงเส้นสูง
ฟังก์ชันเคอร์เนล RBF ถูกกําหนดไว้ดังนี้:
$$ K(\mathbf{x}_i, \mathbf{x}_j) = \exp\left(-\gamma \|\mathbf{x}_i - \mathbf{x}_j\|^2\right) $$โดยที่ $\gamma$ เป็นพารามิเตอร์ที่กําหนดความกว้างของฟังก์ชันเกาส์เซียน และ $\|\mathbf{x}_i - \mathbf{x}_j\|^2$ คือระยะทางยูคลิดยกกําลังสองระหว่างเวกเตอร์อินพุต
ฟังก์ชันการตัดสินใจสําหรับเคอร์เนล RBF คือ:
$$ f(\mathbf{x}) = \sum_{i=1}^{n} \alpha_i y_i \exp\left(-\gamma \|\mathbf{x} - \mathbf{x}_i\|^2\right) + b $$โดยที่ $\alpha_i$ คือตัวคูณลากรังจ์, $y_i$ คือป้ายกํากับคลาส และ $b$ คือเทอมไบแอส
เคอร์เนลซิกมอยด์
เคอร์เนลซิกมอยด์มีพื้นฐานมาจากฟังก์ชันซิกมอยด์ ซึ่งมักใช้ในเครือข่ายประสาทเทียมมันสามารถแมปข้อมูลอินพุตไปยังพื้นที่มิติสูงกว่า คล้ายกับ RBF แต่ใช้กันน้อยกว่าฟังก์ชันเคอร์เนลซิกมอยด์ถูกนิยามว่า:
$$ K(\mathbf{x}_i, \mathbf{x}_j) = \tanh\left(\gamma \mathbf{x}_i \cdot \mathbf{x}_j + c\right) $$โดยที่ $\alpha$และ $c$ คือพารามิเตอร์ของเคอร์เนล และ $\tanh$ คือฟังก์ชันสัมผัสไฮเปอร์โบลิก
ฟังก์ชันการตัดสินใจสําหรับเคอร์เนลซิกมอยด์คือ:
$$ f(\mathbf{x}) = \tanh\left(\sum_{i=1}^{n} \gamma_i y_i (\mathbf{x} \cdot \mathbf{x}_i) + c\right) $$โดยที่ $\alpha_i$ คือตัวคูณลากรังจ์, $y_i$ คือป้ายกํากับคลาส และ $c$ คือพารามิเตอร์
SVM สูตรคู่
ปัญหาการหาค่าที่เหมาะสมมักถูกแก้โดยใช้สูตรคู่ของมันปัญหาคู่เน้นการหาตัวคูณลากรังจ์ $\alpha_i$ ที่เป็นไปตามเงื่อนไขดังต่อไปนี้:
$$ \max_{\alpha} \sum_{i=1}^{n} \alpha_i - \frac{1}{2} \sum_{i=1}^{n} \sum_{j=1}^{n} \alpha_i \alpha_j y_i y_j K(\mathbf{x}_i, \mathbf{x}_j) $$ขึ้นอยู่กับ:
$$ 0 \leq \alpha_i \leq C \quad \forall i $$และ
$$ \sum_{i=1}^{n} \alpha_i y_i = 0 $$โดยที่ $K(\mathbf{x}_i, \mathbf{x}_j)$ คือฟังก์ชันเคอร์เนลที่คํานวณผลคูณจุดในพื้นที่ฟีเจอร์ที่แปลงแล้ว
การปรับแต่งขั้นต่ําแบบลําดับ
อัลกอริทึม SMO ทํางานดังนี้:- เริ่มต้นตัวคูณลากรังจ์ $\alpha_i$ ให้เป็นศูนย์
- รายการ ทําซ้ําจนกว่าจะบรรลุเป้าหมาย:
- เลือกตัวคูณสองตัว $\alpha_i$ และ $\alpha_j$ ที่ละเมิดเงื่อนไข Karush-Kuhn-Tucker (KKT)
- แก้ปัญหาการหาค่าที่เหมาะสมสําหรับตัวคูณทั้งสองนี้ในขณะที่ยังคงค่าตัวคูณอื่น ๆ ไว้
- อัปเดตตัวคูณและเวกเตอร์น้ําหนักที่เกี่ยวข้อง $\mathbf{w}$ และเทอมไบแอส $b$
ข้อดีของอัลกอริทึม SMO คือมันแยกปัญหาการเขียนโปรแกรมกําลังสองขนาดใหญ่ออกเป็นชุดปัญหาขนาดเล็กที่แก้ไขได้ง่ายและรวดเร็วกว่า
การเพิ่มประสิทธิภาพของตัวคูณลากรังจ์สองตัว $\alpha_i$ และ $\alpha_j$ สามารถแสดงได้ดังนี้:
$$ \max_{\alpha_i, \alpha_j} \left( \alpha_i + \alpha_j - \frac{1}{2} \left( \alpha_i^2 K(\mathbf{x}_i, \mathbf{x}_i) + \alpha_j^2 K(\mathbf{x}_j, \mathbf{x}_j) + 2 \alpha_i \alpha_j K(\mathbf{x}_i, \mathbf{x}_j) \right) \right) $$ภายใต้ข้อจํากัดดังนี้:
$$ 0 \leq \alpha_i, \alpha_j \leq C $$และ
$$ y_i \alpha_i + y_j \alpha_j = \text{constant} $$ปัญหาการหาค่าที่เหมาะสมแบบกําลังสองนี้แก้ไขได้ง่ายกว่ามาก และอัลกอริทึม SMO จะอัปเดตตัวคูณซ้ํา ๆ เพื่อหาคําตอบที่เหมาะสมที่สุด## อ้างอิง
[1] V. K. Chauhan, K. Dahiya, และ A. Sharma. การกำหนดปัญหาและตัวแก้ปัญหาใน SVM เชิงเส้น: การทบทวน. Artificial Intelligence Review, 52(2):803–855, 2019.
[2] J. Platt. การเพิ่มประสิทธิภาพน้อยลำดับ: อัลกอริธึมเร็วสำหรับการฝึกเครื่องเวกเตอร์สนับสนุน. 1998.